


Селектор — це адреса значення на сторінці. Коли ви налаштовуєте парсинг сайту, ви не показуєте програмі колонку з ціною, як у файловому прайсі, а пишете, в якому місці розмітки ця ціна написана. Ця стаття — довідник таких адрес: що підтримує наш розбір, як виглядає робочий селектор під кожне поле товару й чому найчастіше не знаходиться нічого.
Порядок налаштування правил, вкладки, кнопки тесту й помічники описані окремо — у статті про парсинг сайтів. Тут лише мова селекторів і приклади.
Дві мови: CSS і XPath
Селектор пишуть однією з двох мов. За замовчуванням у комірці чекають CSS-селектор — той самий, яким верстальники описують стилі. Якщо зручніше XPath, у тому самому рядку правила ставлять галочку «XPath».
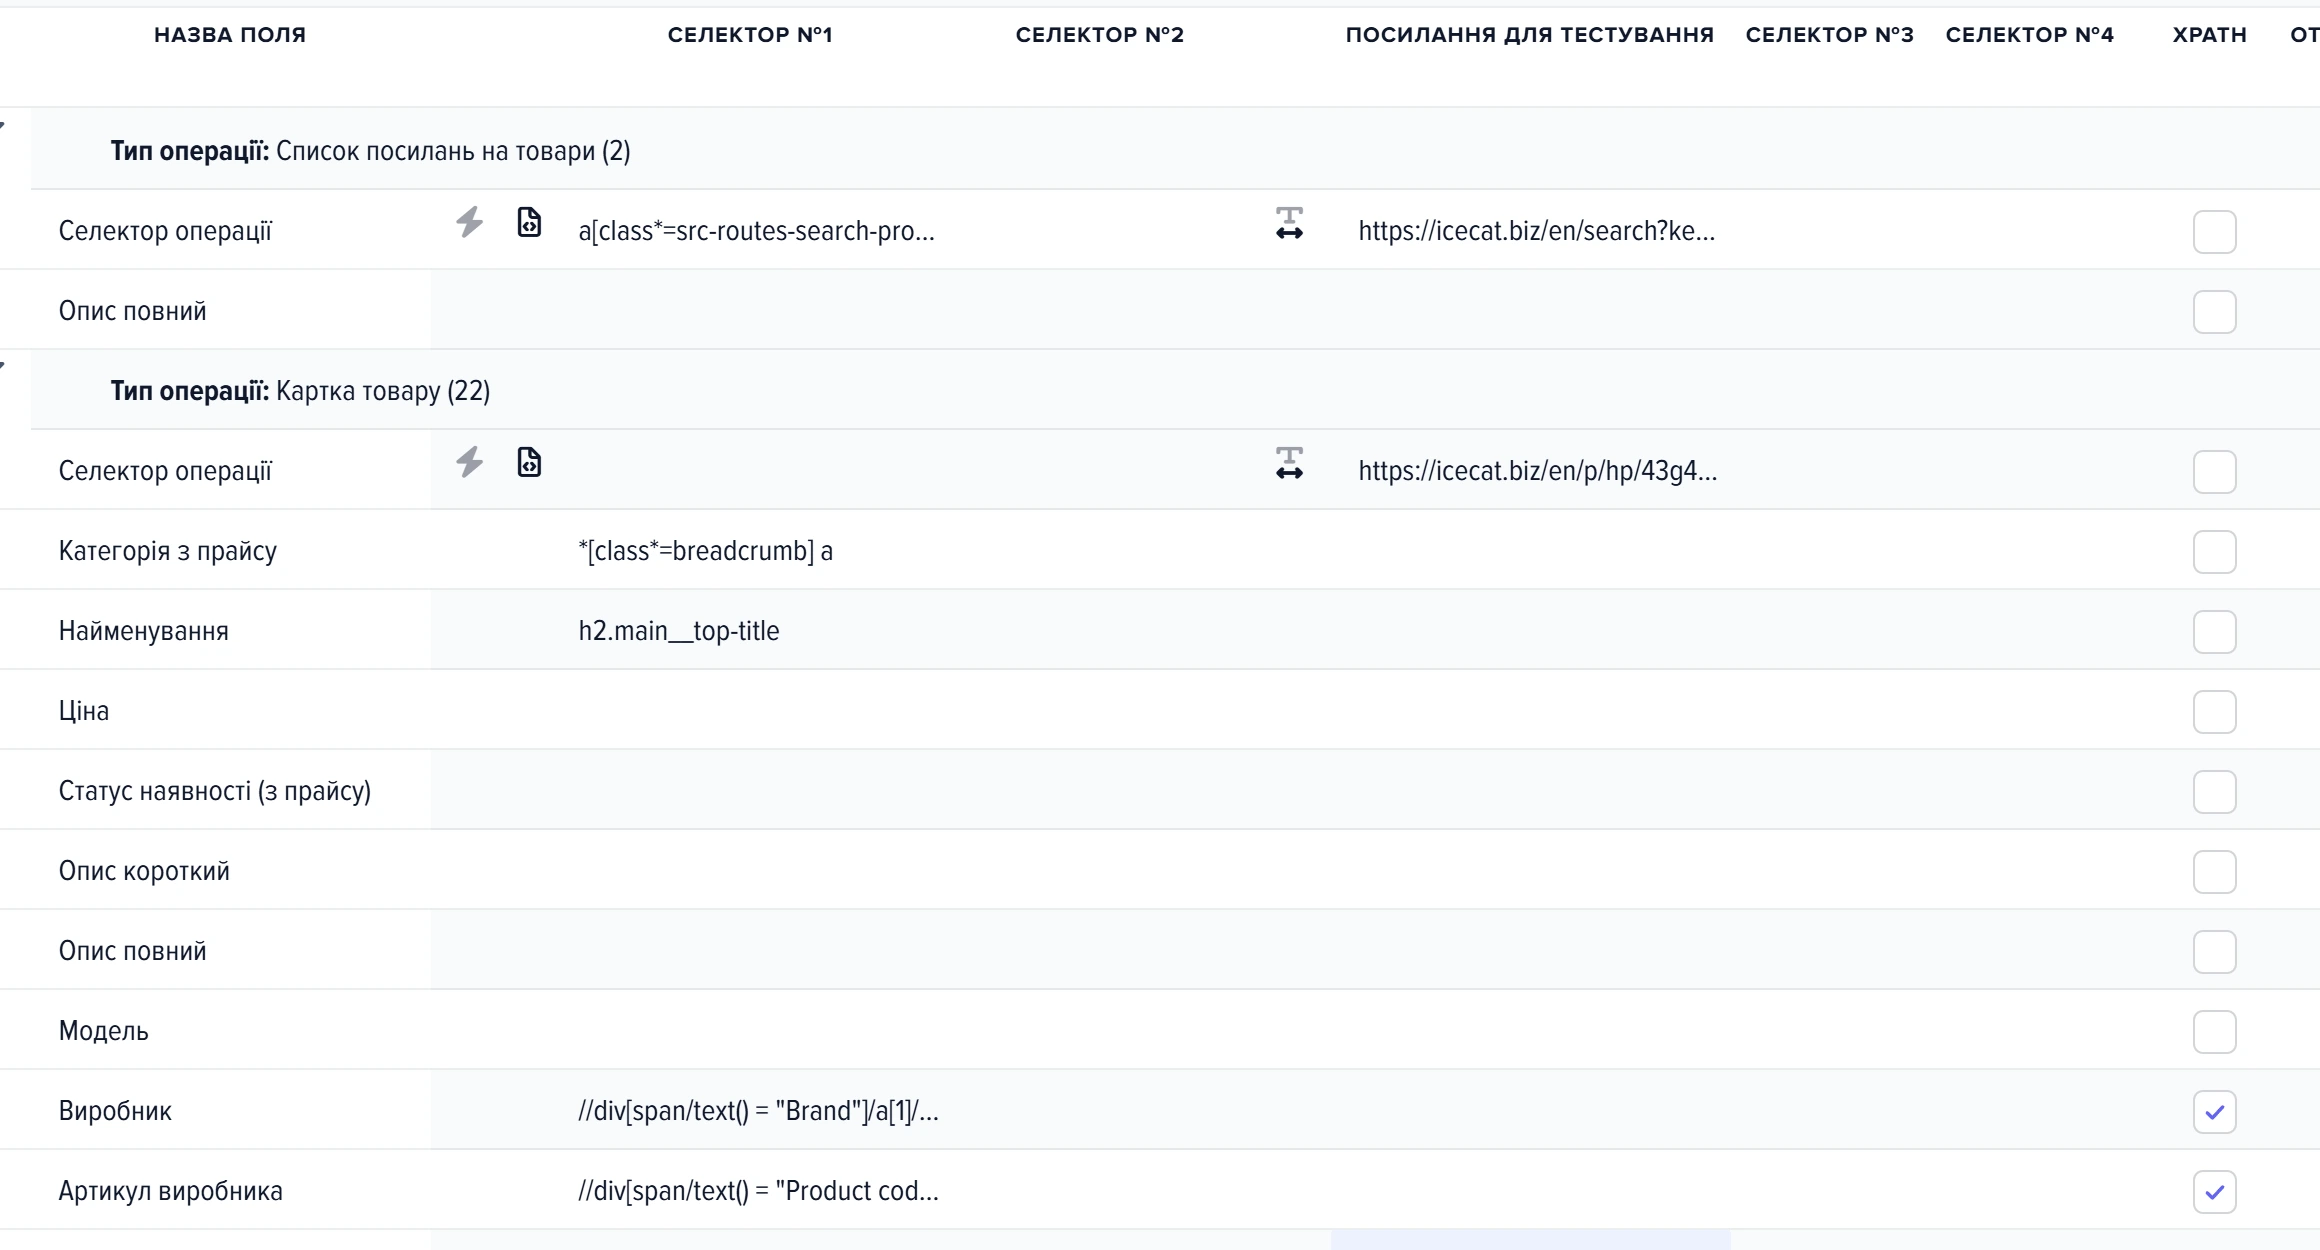
1
Селектор операції2
Позначка XPath3
Поле «Ціна»- Колонка «Селектор операції» — сюди вписують адресу значення на сторінці.
- Позначка «XPath» у рядку — без неї XPath обриває розбір усієї сторінки, а не просто не знаходить значення.
- Рядок поля «Ціна» — у кожного поля свій селектор, налаштовуються вони незалежно.
Галочка не косметична. XPath, вписаний у рядок без неї, не «нічого не знаходить» — розбір цієї сторінки обривається з помилкою. У журналі при цьому буде код відповіді 200, тобто зовні все ніби добре, а даних немає. Так само обривається розбір на CSS-селекторі з синтаксичною помилкою: зайва дужка коштує цілої сторінки.
Різниця між «нічого не знайшов» і «помилка» важлива для пошуку причини. Селектор, який просто не знайшов елемента, дає порожній результат і йде далі — інші поля з тієї ж сторінки приїдуть нормально. Селектор із помилкою зупиняє всю сторінку.
Базовий набір: тег, клас, атрибут
Чотири способи вказати елемент, з яких складається майже будь-який робочий селектор:
| Запис | Що вибирає |
|---|---|
h1 | усі теги h1 на сторінці |
.price | усе з класом price |
#product-card | елемент із таким id |
span[itemprop=price] | span із таким атрибутом |
div.card > a | посилання, яке лежить безпосередньо в div.card |
div.card a | посилання будь-де всередині div.card, хоч на п'ятому рівні вкладеності |
У квадратних дужках працює не лише точна рівність. Перед знаком рівності ставлять символ, який змінює правило порівняння:
| Оператор | Умова | Приклад |
|---|---|---|
= | значення точно таке | a[rel=nofollow] |
^= | починається з | a[href^=/product/] |
$= | закінчується на | img[src$=.jpg] |
*= | містить підрядок | a[href*=catalog] |
!= | значення інше | input[type!=hidden] |
~= | містить таке слово у списку через пробіл | div[class~=in-stock] |
|= | дорівнює або починається з «значення-» | span[lang|=uk] |
Оператор *= рятує на сайтах, де класи згенеровані складачем і виглядають як price__value_a7f3: div[class*=price__value] переживе зміну хвоста, а div.price__value_a7f3 — ні.
Повний перелік псевдокласів
Псевдоклас звужує вибірку за позицією або вмістом. Наш розбір підтримує рівно цей набір — усе інше, що можна побачити в довідниках CSS, тут не спрацює:
| Псевдоклас | Що робить |
|---|---|
:first-child, :last-child | перший або останній серед сусідів |
:nth-child(n), :nth-last-child(n) | n-й за порядком, від початку або від кінця |
:first-of-type, :last-of-type, :nth-of-type(n) | те саме, але рахуються лише елементи того ж тега |
:only-child | єдина дитина в батька |
:empty, :not-empty | порожній / непорожній елемент |
:contains(текст) | містить текст |
:has(селектор) | всередині є елемент за селектором |
:not(селектор) | усе, крім того, що підходить під селектор |
:checked, :disabled, :enabled | стан елементів форми |
У :contains() є два необов'язкові уточнення. Другий аргумент вмикає й вимикає врахування регістру, третій вимагає збігу цілком, а не входження:
td:contains(Гарантія)— містить це слово, регістр важливий;td:contains(гарантія, false)— регістр не важливий;td:contains(Гарантія, true, true)— текст комірки дорівнює саме цьому слову.
Коли регістр важливий (:contains(текст) або другий аргумент true), :contains() дивиться на власний текст елемента, а не на текст усіх нащадків разом. Якщо в розмітці <div><span>Гарантія</span></div>, то div:contains(Гарантія) не знайде нічого, а span:contains(Гарантія) знайде. Це найчастіша причина «псевдоклас не працює». З другим аргументом false перевіряється весь текст разом із вкладеними тегами, тож div:contains(гарантія, false) цей div знайде.
Забрати атрибут, а не текст
За замовчуванням із знайденого елемента береться його текст. Щоб узяти значення атрибута, до селектора дописують ::attr(ім'я). Без цього половина сайтів не збирається — ціна й наявність часто лежать не в тексті, а в розмітці для пошукових систем.
| Завдання | Селектор |
|---|---|
| Посилання на товар | a.product-link::attr(href) |
| Ціна з мікророзмітки | meta[itemprop=price]::attr(content) |
| Фото з відкладеним завантаженням | img.photo::attr(data-src) |
| Фото з набору розмірів | img.photo::attr(srcset) |
| Артикул із службового атрибута | div[data-sku]::attr(data-sku) |
srcset обробляється по-різному на різних кроках. В операції «Картка товару» програма сама вибирає з набору посилання з найбільшою шириною — тобто повний розмір, а не прев'ю. У списку товарів такого відбору немає: там береться останнє посилання з набору. Якщо з лістингу приїжджають маленькі картинки, беріть інший атрибут — зазвичай поруч є data-src або src із повним розміром.
Рецепти під поля товару
Типові випадки, з яких складається більшість налаштувань. Класи в прикладах — вигадані, підставляйте свої; цінна тут форма запису.
| Що треба | Як зазвичай написано в розмітці | Селектор |
|---|---|---|
| Назва товару | єдиний h1 на сторінці | h1 |
| Назва в лістингу | текст посилання на картку | div.catalog a.name |
| Ціна | окремий блок із валютою поруч | div.price-current |
| Ціна в мікророзмітці | атрибут, тексту немає | meta[itemprop=price]::attr(content) |
| Стара ціна — щоб її НЕ взяти | лежить поруч із чинною | div.price:not(.price-old) |
| Артикул | рядок «Код: 12345» | span.sku + «Регулярний вираз» у тому ж рядку правила |
| Наявність | підпис «Є в наявності» | div.stock |
| Наявність за класом | клас змінюється, тексту немає | div[class*=in-stock] |
| Усі фото галереї | посилання на повний розмір | a[data-fancybox=gallery]::attr(href) |
| Тільки ті картки, де є картинка | у списку трапляються рядки-заглушки | div.card:has(img) a::attr(href) |
| Значення характеристики | таблиця «назва — значення» | tr:contains(Вага) td:last-child |
| Опис | блок із розміткою, яку треба зберегти | div.description + галочка «Отримувати HTML» |
| Посилання на другу сторінку розділу | нумерація внизу | ul.pagination a:not(.active)::attr(href) |
Останній рядок таблиці з характеристикою варто прочитати уважно: tr:contains(Вага) td:last-child бере рядок таблиці, у якому є слово «Вага», і з нього — останню комірку. Це надійніше, ніж рахувати рядки за номером: у різних товарів набір характеристик різний, і tr:nth-child(4) у кожного другого товару вкаже не туди.
Коли потрібен XPath
CSS вистачає у більшості випадків, і починати краще з нього — він коротший і його простіше прочитати через півроку. XPath беруть тоді, коли треба піднятися вгору по дереву або перевірити умову, якої в CSS немає.
| Завдання | XPath |
|---|---|
| Взяти батька знайденого елемента | //span[@class="sku"]/.. |
| Комірка праворуч від комірки з текстом | //td[text()="Вага"]/following-sibling::td[1] |
| Другий блок із класом | (//div[@class="price"])[2] |
| Елемент за точним текстом | //a[normalize-space(text())="Купити"] |
Не забудьте про галочку «XPath» у тому ж рядку — без неї сторінка не розбереться взагалі.
Чому селектор нічого не знаходить
| Симптом | Найімовірніша причина | Що зробити |
|---|---|---|
| Порожньо на всіх полях сторінки | у якомусь із правил синтаксична помилка або XPath без галочки — розбір обірвався | перевірте всі правила операції, а не тільки те, яке «не працює» |
| Порожньо в одному полі | селектор не знайшов елемента | подивіться розмітку сторінки очима: клас міг бути з іншим написанням або взагалі згенерованим |
| Приїхала порожня назва, хоча на сайті вона є | значення промальовується скриптом уже в браузері, у вихідній розмітці його немає | увімкніть режим із виконанням скриптів у налаштуваннях джерела |
| Замість тексту — сміття з розмітки | увімкнена галочка «Отримувати HTML» | зніміть її або звузьте список дозволених тегів |
| Замість ціни приїхав нуль | селектор вказує на блок, де ціна написана словами або лежить в атрибуті | візьміть ::attr(content) з мікророзмітки |
| Беруться всі фото разом із іконками | селектор занадто широкий, наприклад просто img | звузьте до контейнера галереї: div.gallery img::attr(src) |
| Селектор працював, а після оновлення сайту зламався | довгий ланцюжок на кшталт div:nth-child(3) > div > span ламається від зайвого банера | перепишіть коротше — за класом або атрибутом |
Псевдоклас :contains() не спрацьовує | текст лежить у вкладеному тегу, а не у власному тексті елемента | вкажіть той тег, у якому текст написаний безпосередньо |
Сценарії
У рядку кожного поля є чотири колонки для селекторів — від «Селектор №1» до «Селектор №4». В операції «Картка товару» програма перебирає їх по порядку й зупиняється на першому, який дав значення. Виняток — фото: для нього застосовуються всі заповнені. Спершу програма шукає блок картки за селектором операції; якщо в рядку операції селектора немає, блоком вважається вся сторінка, а якщо блок не знайдено — поля картки не заповнюються. На цьому порядку тримаються всі сценарії нижче.
Ціна акційного товару лежить в іншому блоці
Задача: на звичайних товарах ціна в одному блоці, на акційних звичайного блоку немає, а ціна стоїть в іншому.
Що ввімкнути: у рядку «Ціна» операції «Картка товару» в «Селектор №1» — блок звичайної ціни, у «Селектор №2» — блок акційної.
Що вийде: там, де перший селектор знайшов ціну, вона й записується. Другий селектор застосовується тільки тоді, коли після першого поле лишилось порожнім. Блок, у якому немає жодної цифри, дає ціну 0.00 — таке значення не записується, і програма переходить до наступного селектора. Чого не станеться: дві ціни не склеяться. Якщо один селектор знайшов кілька цін, у поле піде перша ненульова з них.
Значення за замовчуванням, коли на сторінці його немає
Задача: у частини товарів постачальник пише статус наявності, а в решти блоку немає зовсім, і таким товарам потрібне одне й те саме значення.
Що ввімкнути: у рядку «Статус наявності (з прайсу)» операції «Картка товару» в «Селектор №1» — блок статусу, у «Селектор №2» — потрібний текст у фігурних дужках, наприклад {Під замовлення}.
Що вийде: текст у фігурних дужках — це не адреса на сторінці, а готове значення: програма бере його без дужок і нічого не шукає. Оскільки «Селектор №2» застосовується лише до порожнього поля, товари з блоком статусу отримають текст зі сторінки, а решта — Під замовлення. Чого не станеться: якщо поставити дужки в «Селектор №1», значення з сайту не забиратиметься зовсім — поле отримає цей текст у кожного товару, а наступні селектори рядка не застосовуються.
Артикул записаний як «Код: 12345»
Задача: в артикулі потрібні тільки цифри, а на сторінці поруч стоїть підпис.
Що ввімкнути: у рядку «Артикул контрагента» або «Артикул виробника» — селектор на блок з артикулом, наприклад span.sku.
Що вийде: у цих двох полях слова «Артикул», «Арт.», «Код товару», «Код», «SKU» і двокрапка вирізаються автоматично, регулярний вираз для цього не потрібен. Для іншого формату, наприклад коли артикул стоїть у дужках після назви, заповніть «Регулярний вираз» із круглими дужками навколо потрібного шматка: у поле піде вміст перших дужок першого збігу. Чого не станеться: якщо вираз нічого не знайшов, значення не стирається — у поле піде те, що повернув селектор.
Повний опис з абзацами й картинками
Задача: перенести опис товару з розбивкою на абзаци й списки, а не суцільним текстом.
Що ввімкнути: у рядку «Опис повний» — селектор на блок опису, галочку «Отримувати HTML» і в колонці «Дозволені HTML теги» — перелік тегів, які треба зберегти, наприклад <p><ul><li><img loading="lazy" alt="Селектори CSS і XPath приклади під типові сторінки магазину" title="Селектори CSS і XPath приклади під типові сторінки магазину">.
Що вийде: у поле піде розмітка блоку, у ній лишаться тільки перелічені теги. Відносні адреси картинок усередині опису доповнюються адресою сайту. Атрибут style і HTML-коментарі прибираються незалежно від налаштувань. Якщо селектор знайшов кілька блоків, вони з'єднуються пробілом, а не значенням із «Розділювач значення». Чого не станеться: без галочки «Отримувати HTML» і з порожньою колонкою «Дозволені HTML теги» усі теги видаляються й опис приїде одним текстом.
Фото з галереї і окремо головне фото
Задача: на сторінці головне фото лежить окремо від галереї, і потрібні обидва.
Що ввімкнути: у рядку фото (у колонці «Назва поля» він підписаний image) в «Селектор №1» — посилання галереї, наприклад div.gallery a::attr(href), у «Селектор №2» — головне фото, наприклад img.main::attr(src).
Що вийде: для фото програма не зупиняється на першому селекторі, що спрацював, а застосовує всі заповнені й збирає знайдене в один список. Адреси, у яких трапляється placeholder, no-photo, no-image, no_image, empty або /brand/, відкидаються поштучно — решта фото лишається. Чого не станеться: заглушка «немає фото» не стане головним фото товару.
Часті питання
Звідки взяти селектор, якщо я не верстальник?
Найпростіше — відкрити сторінку в браузері, натиснути на потрібному значенні правою кнопкою й вибрати «Переглянути код». Браузер підсвітить рядок розмітки: у ньому видно тег, клас і атрибути, з яких складається селектор. У самій програмі поруч із правилами є ШІ-помічник: йому віддають шматок розмітки, він відповідає готовим селектором.
Браузер дає дуже довгий селектор. Його можна вставляти?
Технічно так, працюватиме. Практично — він проживе до першої перемальовки сайту: ланцюжок із :nth-child ламається навіть від зайвого банера в блоці. Візьміть із цього ланцюжка найближчий клас або атрибут і напишіть коротко.
Що буде, якщо селектор знайшов кілька елементів?
Вони склеюються через роздільник, заданий у тому ж рядку правила в колонці «Розділювач значення». Якщо колонка порожня — через кому з пробілом. Для категорії й фото колонка не діє: категорії завжди склеюються скісною рискою з пробілами, фото — трьома вертикальними рисками. З галочкою «Отримувати HTML» роздільником завжди стає пробіл. Для полів, де потрібне одне значення, звужуйте селектор.
CSS чи XPath — що обрати?
Починайте з CSS: коротше й зрозуміліше. XPath потрібен, коли треба піднятися до батьківського елемента або взяти сусідню комірку таблиці за текстом — у CSS таких засобів немає.
Селектор бере «Код: 12345», а потрібні лише цифри. Як бути?
Це вже не завдання селектора. У тому самому рядку правила є колонка «Регулярний вираз» — вона витягає шматок зі знайденого значення. Поруч працюють «Знайти» / «Замінити» і «Текст для очищення», якщо достатньо простої заміни.
Як перевірити селектор, не запускаючи весь збір?
У рядку правила є кнопка тесту: вона відкриває сторінку, адресу якої ви вказали в колонці «Посилання для тестування», і показує, що повернув селектор. Порожня колонка з адресою — і кнопка просто нічого не зробить, без жодного повідомлення.
Суміжні теми
- Парсинг сайтів — де саме вписуються ці селектори, як влаштований обхід і як читати журнал.
- Що саме забирає парсер із картки товару — повний перелік полів, які можна зібрати.
- Розширення Elbuz для Chrome — коли збір іде з браузера, а не з сервера.